Ce cours réunit 5 parties : 1. Fréquences, risques et personnes-temps ; 2. Plans d’étude et essais randomisés ; 3. Associations et impact en santé publique ; 4. Biais, confusion et raisonnement causal ; 5. Standardiser et comparer des populations.
Partie 1 · Fréquences, risques et personnes-temps
Prérequis et objectifs
Savoir distinguer un stock, un flux et un temps d’observation. Définir l’événement et la population à risque.
À l’issue de ce cours, vous devez pouvoir :
- Calculer prévalence, risque et taux d’incidence.
- Construire un dénominateur en personnes-temps.
- Interpréter les variations de fréquence.
Fondements du thème
Fréquence, risque et temps
L'épidémiologie étudie la distribution des états de santé, leurs déterminants et les moyens d'agir sur eux dans des populations définies. Décrire une fréquence suppose de préciser les personnes, le lieu, la période et une définition des cas. Une hausse du nombre de diagnostics peut résulter d'une augmentation réelle de la maladie, mais aussi d'un dépistage plus intense, d'une nouvelle définition ou d'une population plus grande.
La prévalence est la proportion de personnes présentant un état à un instant ou sur une période précisée. L'incidence cumulée est la proportion de nouveaux cas parmi les personnes initialement à risque au cours d'une période. Elle correspond à un risque sous les conditions d'une cohorte et d'un suivi adaptés. Le taux d'incidence rapporte les nouveaux cas au temps-personne à risque ; il s'exprime par exemple en cas pour 1000 personnes-années et n'est pas directement une probabilité.
Prévalence et durée
Une maladie longue peut être très prévalente malgré une faible incidence. Dans un modèle stationnaire simplifié de maladie rare, prévalence ≈ incidence × durée moyenne. Cette approximation suppose notamment une stabilité du système et ne remplace pas un modèle dynamique lorsque l'incidence, la survie ou les migrations changent. Améliorer la survie peut augmenter la prévalence même si la prévention réduit les nouveaux cas.
Le taux de mortalité rapporte les décès au temps ou à la population considérée ; la létalité rapporte les décès dus à une maladie aux personnes atteintes selon une période et une définition explicites. Une maladie fréquente mais peu létale peut causer davantage de décès qu'une maladie très létale mais rare. Les statistiques doivent donc conserver leur dénominateur.
Comparer des populations
Un taux brut dépend de la composition de la population. Une région plus âgée peut présenter une mortalité brute plus forte sans avoir des taux de mortalité plus élevés à âge égal. La standardisation directe applique les taux par strates d'âge à une même population de référence. Elle construit une comparaison ajustée sur cette structure, mais ne corrige pas tous les autres facteurs.
La standardisation indirecte applique des taux de référence à la population étudiée pour calculer un nombre attendu. Le rapport observé/attendu peut résumer l'écart, avec ses limites de comparabilité. Une estimation doit être accompagnée d'une incertitude et d'informations sur la qualité des données. Les petits nombres produisent des fluctuations importantes, particulièrement dans de petites zones géographiques.
Développements et raisonnements
Une définition de cas peut changer le nombre observé
Avant de compter, une enquête précise les critères cliniques, biologiques, temporels et géographiques qui qualifient un cas. Une définition plus sensible peut augmenter le nombre recensé sans augmentation identique du phénomène biologique. Modifier une méthode de mesure pendant une série temporelle crée une rupture qu’il faut documenter. Les cas possibles, probables et confirmés ne doivent pas être fusionnés sans préciser la règle.
La population à risque exclut les personnes qui ne peuvent pas connaître l’événement défini au début de l’intervalle. Dans une étude de première occurrence, une personne déjà atteinte ne contribue pas au dénominateur des nouveaux premiers cas. Pour des événements récurrents, la construction du dénominateur demande d’autres règles : une personne peut redevenir exposée au risque après un épisode.
Pourquoi les personnes-temps sont utiles
Une cohorte ouverte accueille des personnes à des dates différentes et peut perdre leur suivi. Chaque participant contribue son temps effectivement observé à risque. Additionner ces durées donne un dénominateur en personnes-années ou personnes-mois. Dix personnes suivies un an et une personne suivie dix ans représentent le même total arithmétique, mais pas nécessairement la même information si l’âge, la période ou le taux varient.
Un taux peut dépasser un événement par personne-année lorsqu’on compte des épisodes répétés ou un événement fréquent sur une unité de temps longue. Une probabilité reste entre zéro et un. Pour un hazard constant λ et sans événements concurrents, le risque sur t est 1 − exp(−λt). L’approximation λt n’est bonne que lorsque ce produit est faible.
Relier prévalence et durée avec prudence
Le stock de cas augmente par les nouveaux cas et diminue par guérison, décès ou sortie de population selon la définition. Une meilleure survie peut augmenter le stock même si l’incidence baisse. Une enquête de prévalence surreprésente les maladies de longue durée par rapport aux épisodes brefs. Elle peut donc donner une image différente des causes des nouveaux événements.
| Indicateur | Numérateur | Dénominateur | Temps requis |
|---|---|---|---|
| Prévalence ponctuelle | Cas présents | Population présente | Date |
| Risque cumulé | Nouveaux cas | Personnes initialement à risque | Durée de suivi |
| Taux d’incidence | Nouveaux cas | Temps à risque | Unité de temps |
| Létalité | Décès attribués à la maladie | Cas de cette maladie | Fenêtre définie |
Une variation relative de taux doit s’accompagner des niveaux absolus et de leur incertitude. Passer de un à deux événements est un doublement, mais les petits effectifs donnent une forte instabilité. Le même pourcentage appliqué à des milliers de cas possède une précision différente.
Atelier de calcul et analyse de sensibilité
Cinq personnes initialement indemnes contribuent respectivement 1,0 ; 1,0 ; 0,5 ; 0,8 et 0,7 année avant événement, fin de suivi ou sortie. Le temps total vaut 4,0 personnes-années. Si deux événements sont observés, le taux est 0,50 par personne-année. Diviser deux par cinq donne une proportion de 40 %, mais celle-ci ne constitue pas automatiquement un risque à un an puisque les suivis sont incomplets et inégaux.
Dans un modèle à hazard constant λ = 0,10/an, le risque à un an vaut 1 − e⁻⁰·¹ = 9,516 %. À cinq ans, il vaut 1 − e⁻⁰·⁵ = 39,347 %, et non 50 %. Le taux reste constant tandis que le risque cumulé augmente sans dépasser 100 %. La formule suppose une population homogène et aucune concurrence d’autres événements pour l’issue étudiée.
Une population stationnaire fictive possède une incidence de 2 nouveaux cas pour 1000 personnes-années et une durée moyenne de maladie de 5 ans. L’approximation de maladie rare donne une prévalence de 10 pour 1000, soit 1 %. Si la durée double à incidence inchangée, le stock attendu double. Ce résultat explique un mécanisme possible, mais ne permet pas de déduire la durée réelle d’une maladie à partir d’une photographie sans vérifier la stationnarité.
Approfondissement et contrôle du modèle
Surveillance : distinguer événement et notification
La date de survenue, la date de diagnostic et la date de déclaration peuvent différer. Une augmentation des notifications sur une semaine peut correspondre au rattrapage de dossiers anciens. Pour interpréter une courbe, il faut savoir quelle date a servi au classement et si les délais de remontée ont changé.
Un système de surveillance peut privilégier la rapidité au prix d’une certaine incomplétude initiale, puis réviser les nombres. Comparer une période récente encore incomplète à une période ancienne consolidée peut produire une baisse artificielle. Une définition de cas stable, un dénominateur cohérent et une analyse des retards améliorent la lecture. Ces précautions n’empêchent pas d’agir face à un signal ; elles précisent le degré de certitude attaché aux données disponibles.
Mise à l’épreuve : Définir le temps à risque avant d’additionner
Problème. Trois personnes sont observées pendant un an. A présente le premier événement à 0,2 an, B reste indemne un an et C quitte le suivi indemne à 0,6 an. Calculer le taux de première occurrence.
Résolution. Pour ce critère, A cesse de contribuer au temps à risque à son événement. Le total est 0,2 + 1 + 0,6 = 1,8 personne-année et le taux 1/1,8 = 0,556 événement par personne-année. Employer 2,6 en conservant A jusqu’à la fin répondrait à un autre dénominateur. Le quotient 1/3 est la proportion avec événement observé, mais pas une estimation complète du risque à un an puisque C est censurée. Pour des récidives, la définition du temps à risque et du numérateur changerait : il faut choisir le phénomène avant de calculer.
Schéma de raisonnement
- Définition de cas
- Population à risque
- Période et suivi
- Numérateur et dénominateur
- Interprétation
Schéma de principe : lire les conditions et les limites dans le texte.
Le schéma rappelle que le calcul vient après les définitions. Une série de diagnostics dépend aussi du système de détection.
Exercices progressifs
1. Sur 1000 personnes initialement indemnes suivies intégralement un an, 20 nouveaux cas apparaissent. Incidence cumulée ?
2. Trente cas surviennent sur 6000 personnes-années. Taux d'incidence ?
3. Pourquoi la prévalence peut-elle augmenter après une amélioration du traitement ?
4. Douze événements sont observés sur 2400 personnes-années. Taux pour 1000 personnes-années ?
5. Un hazard constant vaut 0,2/an. Risque à deux ans selon le modèle exponentiel ?
6. Pourquoi compter tous les habitants au dénominateur peut-il être erroné pour une première occurrence ?
Corrections argumentées
1. 20/1000 = 2 % sur un an. Le délai doit accompagner le chiffre ; « 2 % » seul est incomplet.
2. 30/6000 = 0,005 par personne-année, soit 5 cas pour 1000 personnes-années. Cela ne signifie pas automatiquement un risque de 0,5 % pour toute période.
3. Les personnes peuvent vivre plus longtemps avec la maladie. La durée augmente ; le stock de cas présents peut croître même sans augmentation de l'incidence.
4. 12/2400 × 1000 = 5 pour 1000 personnes-années.
5. 1 − exp(−0,4) = 0,32968, soit 32,97 %. Le produit 0,4 est une approximation trop grossière ici pour le risque.
6. Les personnes déjà atteintes ne sont plus à risque de leur première occurrence. Le dénominateur doit correspondre à l’événement précisément étudié.
Références et portée
Sources consultées le 1er octobre 2026 pour les notions signalées. Développements, situations et calculs pédagogiques OSSIK ; données fictives. La concordance complète avec les supports universitaires de l’année et la relecture scientifique humaine restent à réaliser. Les modèles biomédicaux ne fournissent aucune décision thérapeutique individuelle.
Partie 2 · Plans d’étude et essais randomisés
Prérequis et objectifs
Connaître exposition, événement, risque et association. Identifier qui choisit l’exposition et comment les participants sont recrutés.
À l’issue de ce cours, vous devez pouvoir :
- Relier question et plan d’étude.
- Distinguer cohorte, transversal et cas-témoins.
- Comprendre randomisation, aveugle et intention de traiter.
Fondements du thème
Observer ou intervenir
Une étude descriptive caractérise une situation sans nécessairement rechercher un effet causal. Une étude analytique compare des groupes pour examiner une association. Dans une étude observationnelle, le chercheur n'attribue pas lui-même l'exposition ; dans une étude interventionnelle, il organise une intervention. La qualité dépend de l'adéquation entre question, plan, mesures et analyse, pas d'une étiquette isolée.
Une étude transversale observe exposition et état de santé à une période donnée. Elle convient notamment à la prévalence, mais la temporalité est souvent ambiguë : l'exposition a-t-elle précédé la maladie ? Une cohorte suit des personnes selon leur exposition et observe les événements. Elle peut être prospective ou reconstituée à partir de données antérieures ; « rétrospectif » ne veut pas dire automatiquement « cas-témoins ».
Étude cas-témoins
Dans une étude cas-témoins, on sélectionne selon le statut de maladie, puis on compare les expositions. Les témoins doivent représenter la distribution d'exposition dans la population source qui a produit les cas, selon le schéma d'échantillonnage. Choisir des témoins simplement « très sains » peut déformer la comparaison. Le nombre de cas et de témoins étant souvent fixé par le protocole, les proportions observées ne permettent pas directement de calculer un risque absolu de maladie.
L'odds ratio est une mesure naturelle pour ce plan. Son lien avec le risque relatif ou le rapport de taux dépend du mode de sélection des témoins. Dans certains plans classiques, une maladie rare permet d'approcher le risque relatif ; dans un échantillonnage sur les ensembles à risque, l'odds ratio peut estimer un rapport de taux sans cette même condition. Il faut relier la formule au plan réel.
Essai randomisé
La randomisation attribue les groupes par un mécanisme aléatoire. Elle équilibre les facteurs pronostiques en moyenne sur des répétitions, sans garantir des groupes identiques dans chaque petit essai. La dissimulation de la séquence évite de prédire l'affectation au recrutement ; l'aveugle limite certains biais après l'affectation. Ce sont des mécanismes distincts.
L'analyse en intention de traiter conserve les participants dans leur groupe attribué selon les modalités du protocole d'analyse. Elle protège une partie des avantages de la randomisation et renseigne sur l'effet d'une stratégie d'attribution. Les données manquantes restent un problème : l'étiquette intention de traiter ne les résout pas. La validité externe concerne le transfert des résultats à d'autres populations et conditions de soins.
Développements et raisonnements
Reconstituer la logique de sélection
Dans une cohorte, on part d’une population définie et on observe ses événements selon des expositions. La mesure de l’exposition peut avoir eu lieu dans des dossiers anciens : cela reste une cohorte rétrospective si la sélection ne repose pas sur le statut final de cas. Dans une étude cas-témoins, on sélectionne d’abord des cas et des témoins puis on compare leurs expositions. Le calendrier passé ou futur ne suffit donc pas à nommer le plan.
Les témoins doivent représenter la population source qui a produit les cas selon le schéma retenu. Une sélection de témoins hospitalisés pour une maladie liée à l’exposition peut déformer cette représentation. Apparier sur une variable peut faciliter certaines comparaisons, mais demande une analyse respectant l’appariement ; cela ne supprime pas toute confusion.
L’essai compare des stratégies définies
La randomisation crée une comparabilité probabiliste initiale. La dissimulation d’allocation empêche le recruteur de prévoir le groupe avant l’inclusion. L’aveugle réduit les différences de comportement, de mesure ou d’interprétation après l’allocation. Une intervention comme une formation peut être impossible à masquer aux participants tout en permettant un évaluateur du résultat en aveugle.
L’intention de traiter estime généralement l’effet d’assigner une stratégie dans les conditions de l’essai, avec les écarts d’adhésion observés. L’analyse per protocole cherche une autre cible mais peut perdre la comparabilité initiale si l’adhésion est liée au pronostic. Aucune étiquette ne dispense de traiter les données manquantes et les événements intercurrents de façon cohérente avec l’objectif.
Plan, biais et transférabilité
Un essai bien conduit peut exclure certaines populations et utiliser un suivi plus intensif que les soins habituels. Sa validité interne ne garantit pas le même effet ailleurs. Une étude observationnelle plus représentative peut informer l’usage réel tout en étant plus exposée à la confusion. L’évaluation combine la qualité du plan, la pertinence du comparateur et la proximité avec la question.
| Question | Plan possible | Limite à anticiper |
|---|---|---|
| Fréquence actuelle | Transversal | Temporalité limitée |
| Apparition après exposition | Cohorte | Confusion et pertes |
| Expositions d’une maladie rare | Cas-témoins | Sélection des témoins |
| Effet d’une stratégie attribuable | Essai randomisé | Adhésion, éthique, transfert |
Le consentement, la protection des participants et la pertinence scientifique encadrent un essai. Une comparaison inefficace ou une mesure mal choisie ne devient pas acceptable simplement parce que l’attribution est aléatoire. Les règles réglementaires exactes dépendent du type de recherche et du cadre applicable.
Atelier de calcul et analyse de sensibilité
Une cohorte suit 800 personnes exposées et 1200 non exposées pendant une même durée complète. Elle observe 64 et 48 événements. Les risques valent 8 % et 4 %, donc RR = 2. Dans une étude cas-témoins issue de la même population, on pourrait sélectionner tous les cas et un nombre fixé de témoins ; la proportion de cas dans l’échantillon ne représenterait alors plus le risque populationnel.
Un essai randomise 100 personnes par groupe. Dans le groupe A, 20 ne suivent pas l’intervention prévue. Si l’on compare seulement les 80 adhérents aux 100 du groupe B, on a sélectionné après randomisation. Si l’adhésion dépend de la sévérité initiale ou d’effets précoces, les groupes analysés peuvent ne plus être comparables. Une analyse en intention de traiter conserve l’attribution, mais il faut encore savoir si les résultats des 20 personnes sont disponibles.
Une enquête transversale montre que 30 % des personnes présentant des symptômes ont modifié leur alimentation contre 10 % des autres. L’alimentation pourrait contribuer aux symptômes, mais les symptômes pourraient aussi avoir motivé le changement. Définir une période d’exposition antérieure au début des symptômes ou suivre une cohorte aiderait à discuter cette causalité inverse. Le calcul d’une association ne règle pas l’ordre temporel.
Approfondissement et contrôle du modèle
Définir la stratégie comparée
Un essai peut comparer l’offre d’une intervention, sa réception effective ou son usage conforme. Ces questions produisent des effets cibles différents. L’assignation aléatoire identifie plus directement l’effet d’une stratégie d’attribution sous les conditions adaptées ; l’effet de l’adhésion réelle demande de traiter des facteurs qui influencent aussi le pronostic.
Le comparateur doit être décrit avec autant de précision que l’intervention : soins habituels, suivi renforcé et placebo peuvent entraîner des comportements différents. Une prise en charge additionnelle dans un groupe peut contribuer au résultat. Une conclusion portant seulement sur le nom du produit ou du programme peut donc masquer un ensemble plus large d’actions comparées. La reproductibilité exige la description de ces modalités, de leur mise en œuvre et des écarts observés au protocole.
Mise à l’épreuve : Une sélection des adhérents peut amplifier la différence apparente
Problème. Un essai fictif attribue A et B à 100 personnes chacun. Les événements sont 20 sous attribution A et 25 sous attribution B. Dans A, 40 personnes adhérentes ont 2 événements, et 60 non adhérentes en ont 18. Comparer les analyses proposées.
Résolution. Selon l’attribution initiale, les risques observés sont 20 % contre 25 %, différence −5 points. Comparer seulement les adhérents A à tout B donne 5 % contre 25 %, différence −20 points. Ce second résultat ne mesure pas simplement « l’effet chez ceux qui suivent » : l’adhésion sélectionne un groupe qui peut différer en pronostic. La randomisation ne protège plus cette comparaison naïve. Une question per-protocole peut être légitime, mais exige une méthode traitant cette sélection et des hypothèses supplémentaires. Ici, tous les résultats sont supposés observés : le traitement des données manquantes est un problème distinct.
Schéma de raisonnement
- Question cible
- Population source
- Mode de sélection
- Mesures et suivi
- Analyse adaptée
Schéma de principe : lire les conditions et les limites dans le texte.
Le choix du plan est une décision méthodologique. Les catégories ne forment pas une hiérarchie suffisante pour juger seules toute étude.
Exercices progressifs
1. Une enquête mesure aujourd'hui tabagisme et symptômes. Quel plan simple ?
2. Pourquoi ne peut-on pas calculer une incidence à partir de 100 cas et 100 témoins sélectionnés arbitrairement ?
3. Randomisation et aveugle sont-ils synonymes ?
4. Une étude utilise en 2026 des dossiers d’exposition de 2018 puis les événements jusqu’en 2025. Est-elle nécessairement cas-témoins ?
5. Pourquoi une répartition alternée A/B ne constitue-t-elle pas une randomisation dissimulée ?
6. Quelle limite persiste si les critères sont mesurés sans aveugle dans un essai randomisé ?
Corrections argumentées
1. Transversal. La simultanéité des mesures rend souvent l'ordre temporel difficile à établir.
2. Le rapport 100/200 est imposé par l'échantillonnage, pas par la fréquence de la maladie dans la population source ; le temps à risque n'est pas fourni.
3. Non. L'une attribue aléatoirement les groupes ; l'autre masque l'attribution à certains acteurs. Un essai peut être randomisé sans être en aveugle.
4. Non. Si une population a été définie indépendamment de ses événements puis suivie dans les dossiers, il peut s’agir d’une cohorte rétrospective.
5. L’affectation suivante est prévisible. Le recruteur peut influencer qui entre à quel moment, ce qui compromet la comparabilité.
6. La connaissance du groupe peut modifier la mesure ou l’interprétation, surtout pour un critère subjectif. La randomisation ne supprime pas ce biais après allocation.
Références et portée
Sources consultées le 1er octobre 2026 pour les notions signalées. Développements, situations et calculs pédagogiques OSSIK ; données fictives. La concordance complète avec les supports universitaires de l’année et la relecture scientifique humaine restent à réaliser. Les modèles biomédicaux ne fournissent aucune décision thérapeutique individuelle.
Partie 3 · Associations et impact en santé publique
Prérequis et objectifs
Savoir lire un tableau à quatre cases et calculer des proportions. Fixer quel groupe sert de référence.
À l’issue de ce cours, vous devez pouvoir :
- Comparer risque relatif, odds ratio et différence de risques.
- Calculer un impact absolu à une durée donnée.
- Distinguer association observée et fraction causalement attribuable.
Fondements du thème
Risque relatif et différence de risques
Dans une cohorte, notons a les malades exposés, b les non-malades exposés, c les malades non exposés et d les non-malades non exposés. Le risque des exposés est a/(a + b) et celui des non-exposés c/(c + d). Le risque relatif RR est leur quotient. RR = 1 indique l'absence d'association sur cette échelle ; RR > 1 indique un risque plus élevé dans le groupe au numérateur.
La différence de risques DR = R_exposés − R_non_exposés mesure l'excès absolu. Passer de 1 % à 2 % et passer de 20 % à 40 % donnent le même RR = 2, mais des différences absolues très différentes. Communiquer uniquement un effet relatif peut donc masquer l'ampleur concrète d'un effet.
Cote et odds ratio
La cote d'un événement de probabilité p vaut p/(1 − p). L'odds ratio OR compare deux cotes et vaut ad/(bc) dans le tableau précédent. Si les risques sont de 20 % et 10 %, RR = 2, tandis que OR = (0,20/0,80)/(0,10/0,90) = 2,25. L'OR s'éloigne davantage de 1 lorsque l'événement est fréquent ; il ne doit pas être renommé automatiquement risque relatif.
Dans un essai où un traitement réduit le risque de 12 % à 8 % sur un an, la réduction absolue est 4 points de pourcentage. La réduction relative est 1 − 8/12 = 33,3 %. Le nombre nécessaire à traiter, NNT = 1/réduction absolue, vaut 25 personnes sur un an dans ce cadre. Il dépend du risque initial, de la durée et du critère ; ce n'est pas une propriété constante de la molécule.
Attribution et causalité
La fraction attribuable chez les exposés peut s'écrire (RR − 1)/RR si l'exposition est nocive et si l'interprétation causale est justifiée. Elle ne signifie pas que l'on peut identifier quels cas individuels sont « causés uniquement » par l'exposition. Une fraction attribuable populationnelle dépend également de la fréquence de l'exposition dans la population. Les mêmes données peuvent soutenir une association forte sans autoriser un calcul causal fiable en présence de confusion.
Un intervalle de confiance d'un ratio qui contient 1 est compatible avec l'absence d'association au niveau correspondant, selon le test et les hypothèses. Pour une différence, la valeur nulle est 0. La largeur de l'intervalle compte : un résultat imprécis peut rester compatible avec un effet important dans les deux directions.
Développements et raisonnements
Les échelles répondent à des questions différentes
Le rapport des risques décrit une multiplication ; leur différence décrit un nombre supplémentaire de cas par personne. Une réduction relative de 25 % correspond à des diminutions absolues très différentes selon le risque de départ. La communication complète donne les deux risques, la durée et la population. Elle permet de reconstruire les autres mesures sans ambiguïté.
La cote p/(1 − p) compare événements et non-événements. Quand p est petit, 1 − p est proche de 1 et cote ≈ p. Lorsque p augmente, cette approximation devient mauvaise. L’odds ratio n’est pas intrinsèquement une mauvaise mesure ; c’est son interprétation comme risque relatif qui peut être incorrecte. Il reste adapté à plusieurs modèles et plans d’échantillonnage.
Nombre nécessaire et horizon temporel
Si une intervention réduit le risque d’une valeur R0 à R1 sur une durée définie, la réduction absolue est R0 − R1. Son inverse fournit un NNT ponctuel lorsque cette différence est positive. Un NNT de 40 sur trois ans décrit une différence moyenne entre stratégies ; il ne désigne pas à l’avance une personne bénéficiaire parmi quarante ni un nombre de prises.
Le NNT dépend du risque de base, de la durée, de l’adhésion et du transport de l’effet. Lorsque la différence est proche de zéro, son inverse devient très instable. Un intervalle de différence traversant zéro conduit à une interprétation d’incertitude que deux petites bornes de NNT ne résument pas correctement.
Attribuer nécessite une hypothèse causale
La fraction attribuable chez les exposés peut s’écrire (RR − 1)/RR pour un effet délétère causal dans un cadre adapté. La fraction attribuable populationnelle dépend aussi de la fréquence d’exposition. Mais retirer une exposition dans la réalité peut modifier d’autres facteurs ; une association observée ne garantit pas l’effet d’une intervention de suppression.
| Mesure | Référence d’absence d’association | Lecture |
|---|---|---|
| Différence de risques | 0 | Excès ou baisse absolue |
| Risque relatif | 1 | Rapport de probabilités |
| Odds ratio | 1 | Rapport de cotes |
| NNT | Non fini si différence nulle | Inverse d’une réduction absolue |
Des facteurs de confusion, des biais ou une causalité inverse peuvent produire un RR élevé sans effet causal direct. Les mots « attribuable » et « évitable » doivent donc être employés avec les hypothèses qui les autorisent.
Atelier de calcul et analyse de sensibilité
Une intervention fictive réduit sur deux ans le risque de 12 % à 9 %. Le RR vaut 0,75, la réduction relative 25 %, la réduction absolue 3 points et le NNT 1/0,03 = 33,33, souvent arrondi à 34 personnes pour une présentation entière. Dans une population à risque initial de 2 % où le même RR se transporterait, le risque devient 1,5 %, la réduction absolue 0,5 point et le NNT 200. L’effet relatif identique ne produit pas le même impact absolu.
Deux groupes ont des risques de 40 % et 20 %. Le RR est 2, mais l’OR est (0,40/0,60)/(0,20/0,80) = 2,6667. Annoncer « risque multiplié par 2,67 » surestimerait le rapport des risques. Le tableau à quatre cases permet de retrouver séparément les deux mesures.
Dans un modèle causal simplifié, 30 % d’une population sont exposés à un facteur associé à RR = 2. La fraction attribuable populationnelle est p_e(RR − 1)/[1 + p_e(RR − 1)] = 0,30/1,30 = 23,08 %. Ce résultat suppose notamment que le RR utilisé décrive un effet causal transportable et que l’intervention sur l’exposition corresponde à la question. Il ne suffit pas d’insérer n’importe quel OR ajusté dans cette formule.
Approfondissement et contrôle du modèle
Communiquer avec un même dénominateur
Présenter un bénéfice par 1000 personnes et un dommage par 100 personnes rend la comparaison difficile et peut induire une impression trompeuse. Il est préférable d’utiliser la même population fictive de référence, la même durée et des critères nommés. Les pourcentages relatifs restent utiles, mais doivent être rattachés aux risques de départ.
Une différence de risques est une estimation avec une incertitude. Son signe peut être incertain même si l’estimation ponctuelle semble favorable. Les bénéfices et les dommages peuvent aussi avoir des précisions différentes. Une communication honnête ne remplace pas les intervalles par une promesse individuelle. Elle décrit ce qui a été observé dans la comparaison et les hypothèses nécessaires pour l’appliquer à une autre population.
Mise à l’épreuve : Une interaction dépend de l’échelle
Problème. Dans un groupe à faible risque, une exposition fait passer le risque de 1 % à 2 %. Dans un groupe à risque élevé, elle le fait passer de 10 % à 20 %. L’effet est-il identique ?
Résolution. Le RR vaut 2 dans les deux groupes : absence de modification sur cette échelle multiplicative. Les différences valent toutefois +1 et +10 points : elles diffèrent sur l’échelle additive. Sur 1000 personnes de chaque groupe, cela représente respectivement 10 et 100 événements supplémentaires attendus si l’interprétation causale est justifiée. Dire seulement « pas d’interaction » masque le choix d’échelle. On doit annoncer le contraste, sa population et sa durée. Ces nombres décrivent des risques fictifs ; ils ne démontrent ni mécanisme biologique ni causalité sans un plan adapté.
Schéma de raisonnement
- Risques et durée
- Échelle relative
- Échelle absolue
- Population cible
- Hypothèses causales
Schéma de principe : lire les conditions et les limites dans le texte.
Le schéma distingue calcul et attribution. Une fraction calculée ne prouve pas que les cas seraient effectivement évités par une intervention.
Exercices progressifs
1. Les risques sont 30/300 chez les exposés et 10/500 chez les non-exposés. Calcule RR et DR.
2. Pour ces mêmes données, calcule OR.
3. Un risque passe de 10 % à 7 % sur deux ans. Quel NNT conventionnel arrondi ?
4. Un risque passe de 8 % à 6 %. RR, réduction absolue et NNT ponctuel ?
5. Pour p = 0,75, calculer la cote.
6. Pourquoi un NNT sans durée est-il incomplet ?
Corrections argumentées
1. R1 = 0,10 et R0 = 0,02 ; RR = 5 ; DR = 0,08, soit 8 points de pourcentage.
2. a = 30, b = 270, c = 10, d = 490 ; OR = 30 × 490/(270 × 10) ≈ 5,44. Il diffère du RR.
3. Réduction absolue = 0,03 ; 1/0,03 = 33,33, arrondi conventionnellement au supérieur : 34 personnes sur deux ans, pour ce critère et cette population.
4. RR = 0,75 ; réduction absolue = 0,02 ; NNT = 50 sur la durée de l’étude.
5. La cote vaut 0,75/0,25 = 3. Elle peut dépasser un alors qu’une probabilité ne le peut pas.
6. La différence de risques se cumule sur un horizon défini. Une année et dix années n’offrent pas la même possibilité d’événement ni le même impact.
Références et portée
Sources consultées le 1er octobre 2026 pour les notions signalées. Développements, situations et calculs pédagogiques OSSIK ; données fictives. La concordance complète avec les supports universitaires de l’année et la relecture scientifique humaine restent à réaliser. Les modèles biomédicaux ne fournissent aucune décision thérapeutique individuelle.
Partie 4 · Biais, confusion et raisonnement causal
Prérequis et objectifs
Connaître plan d’étude, association et distinction entre exposition et résultat. Raisonner sur les mécanismes de sélection et de mesure.
À l’issue de ce cours, vous devez pouvoir :
- Identifier biais de sélection et information.
- Distinguer confusion, médiation et collision.
- Analyser une modification d’effet selon son échelle.
Fondements du thème
Erreur aléatoire et biais
L'erreur aléatoire produit des fluctuations d'échantillonnage ; augmenter l'effectif la réduit généralement. Un biais est une déviation systématique liée à la conception, à la mesure ou à l'analyse. Recruter davantage de participants selon le même mécanisme biaisé ne le corrige pas. Une étude très précise peut donc estimer précisément une valeur erronée.
Un biais de sélection apparaît lorsque l'entrée ou le maintien dans l'étude déforme la relation étudiée. Une perte de suivi liée à l'exposition et au pronostic peut créer un tel biais. Un biais d'information résulte d'une mesure inadéquate de l'exposition ou du résultat. Le biais de mémorisation survient par exemple si les cas recherchent plus intensément des expositions passées que les témoins.
Confusion, médiation et interaction
Un facteur de confusion est une cause commune, ou une variable liée au mécanisme causal pertinent, pouvant ouvrir une association non causale entre exposition et résultat. Un diagramme simple X ← C → Y montre comment C peut expliquer une partie de l'association entre X et Y. Ajuster sur C peut fermer ce chemin si les hypothèses et mesures sont appropriées. L'ajustement ne doit pas être guidé uniquement par des valeurs p.
Un médiateur se situe sur un chemin X → M → Y. Ajuster sur lui peut retirer une partie de l'effet total que l'on souhaite mesurer. Un collider, ou collisionneur, est une conséquence commune X → S ← Y : conditionner sur S peut créer une association artificielle. Ces distinctions expliquent pourquoi « ajuster sur toutes les variables » n'est pas une règle sûre.
L'interaction ou modification d'effet signifie que l'effet varie selon une autre variable sur une échelle précisée. Elle n'est pas forcément un biais à éliminer : elle peut être un résultat substantiel. Un effet peut être constant sur une échelle relative et variable sur une échelle absolue. Il faut annoncer l'échelle avant d'interpréter une interaction.
Argumenter une cause
La temporalité, la plausibilité, la cohérence entre études et la relation dose-réponse peuvent soutenir une hypothèse causale, mais aucune liste ne fournit une preuve automatique. Une association écologique entre régions ne doit pas être transposée sans précaution aux individus. L'inférence causale confronte des explications alternatives et les limites des données. Un effet crédible doit rester compatible avec la façon dont l'exposition et le résultat ont été définis et mesurés.
Le graphe causal de confusion est X ← C → Y : les deux flèches partent de C. Cette bifurcation ne doit pas être lue comme une chaîne causale C → X → Y.
Développements et raisonnements
Un biais se comprend par son mécanisme
Dire qu’une étude comporte un « biais » ne suffit pas. Il faut décrire qui entre dans l’échantillon, qui en sort, quelle variable est mal mesurée et comment cette erreur dépend de l’exposition ou du résultat. Une erreur de mesure non différentielle ne réduit pas universellement toutes les associations vers zéro ; la direction dépend du modèle et de la variable. Les règles simplistes demandent des conditions précises.
Une perte de suivi plus importante parmi les personnes exposées et malades peut retirer une partie des cas de ce groupe et atténuer une association. Si les pertes sélectionnent surtout les exposés en bonne santé, le sens peut s’inverser. Les taux de pertes par groupe ne révèlent pas à eux seuls le résultat des personnes manquantes ; des analyses de sensibilité rendent explicites plusieurs scénarios.
Trois positions différentes dans un graphe
Une cause commune C avec X ← C → Y ouvre un chemin non causal entre X et Y. Un médiateur M dans X → M → Y transmet une partie de l’effet de X. Une conséquence commune S dans X → S ← Y peut créer une association lorsqu’on conditionne dessus. La liste des variables mesurées ne suffit donc pas à choisir un ajustement ; leur position causale supposée compte.
Le schéma de confusion ne doit pas être dessiné comme une chaîne C → X → Y. Le sens des flèches décrit les hypothèses, non une corrélation statistique symétrique. Ces graphes peuvent aider à identifier ce qu’il faut mesurer, mais ne prouvent pas que les flèches choisies soient vraies.
Modification d’effet et échelle
Supposons qu’une intervention divise le risque par deux dans deux groupes. Si les risques initiaux sont 2 % et 20 %, les baisses absolues sont 1 et 10 points. L’effet est constant sur l’échelle du RR, mais différent sur l’échelle de la différence de risques. Dire « pas d’interaction » sans préciser l’échelle est donc incomplet.
La stratification peut révéler une hétérogénéité d’effet utile à la décision. Elle peut aussi produire des résultats instables lorsque les sous-groupes sont petits ou nombreux. Une différence entre une valeur p significative dans un sous-groupe et non significative dans l’autre ne démontre pas une interaction ; il faut comparer les effets eux-mêmes avec une méthode appropriée.
Validité et précision
Augmenter n réduit certaines fluctuations, mais conserve un décalage systématique si le mécanisme ne change pas. Une étude immense peut alors fournir un intervalle très étroit autour d’une estimation biaisée. La qualité du protocole et des mesures précède le gain de précision numérique.
Atelier de calcul et analyse de sensibilité
Une exposition n’a aucun effet dans chaque tranche d’âge fictive : risque 2 % chez les jeunes et 10 % chez les plus âgés, quel que soit le groupe. Parmi 1000 exposés, 200 sont jeunes et 800 âgés : on attend 4 + 80 = 84 cas, soit 8,4 %. Parmi 1000 non-exposés, 800 sont jeunes et 200 âgés : on attend 16 + 20 = 36 cas, soit 3,6 %. Le RR brut vaut 2,333 alors que les RR par âge valent tous 1. La composition d’âge explique l’association brute de cet exemple.
Une standardisation 50 % jeunes, 50 % âgés donne 0,5 × 2 % + 0,5 × 10 % = 6 % dans les deux groupes. Cela retire le mécanisme de confusion construit ici ; dans des données réelles, d’autres différences peuvent persister. Un ajustement réussi sur l’âge ne garantit pas un effet causal.
Considérons maintenant dix résultats manquants sur cent personnes, avec vingt événements parmi les quatre-vingt-dix observées. La proportion globale serait 20 % si aucun manquant n’avait l’événement et 30 % si tous l’avaient. Le calcul parmi les observés donne 22,22 %. Ces bornes ne sont pas un intervalle de confiance ; elles illustrent une incertitude liée à l’information manquante. Une hypothèse plus plausible doit être justifiée par le mécanisme de suivi.
Approfondissement et contrôle du modèle
Régression vers la moyenne et sélection sur une valeur extrême
Si l’on recrute des personnes sur une mesure exceptionnellement élevée, une seconde mesure peut être plus proche de leur niveau habituel même sans intervention. La première valeur combinait ce niveau et une fluctuation aléatoire favorable à la sélection. Une baisse avant-après peut donc apparaître par régression vers la moyenne.
Un groupe comparateur recruté selon les mêmes critères et suivi avec la même mesure aide à distinguer ce mécanisme d’un effet spécifique. La répétition de mesures avant intervention peut également mieux décrire le niveau initial. Ce phénomène ne signifie pas que toute amélioration soit illusoire ; il explique pourquoi une sélection sur un extrême exige une prudence causale particulière. La taille de l’échantillon ne supprime pas ce mécanisme de conception.
Lecture visuelle : Trois graphes causaux : le rôle du troisième facteur
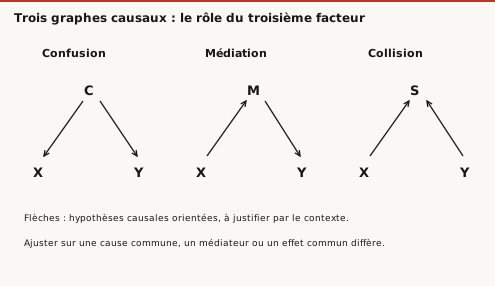
Question de lecture. Ajuster systématiquement sur le troisième facteur est-il toujours une correction ?
Correction. Non. Ajuster sur un médiateur modifie la question d’effet total ; conditionner sur un effet commun peut créer une association. Le rôle de la variable, et non son seul pouvoir prédictif, doit être étudié.
Mise à l’épreuve : Ajuster sur un effet commun peut créer une association
Problème. Deux causes indépendantes A et B peuvent chacune conduire à la sélection S d’un dossier. On étudie uniquement les dossiers sélectionnés, avec S présent si A ou B est présent. Pourquoi A et B deviennent-ils associés dans cet échantillon ?
Résolution. Chez un dossier sélectionné sans A, B est forcément présent. Chez un dossier sélectionné avec A, B peut être présent ou absent. La sélection crée donc une association négative entre A et B, alors qu’elles étaient indépendantes avant sélection. Le graphe est A → S ← B : S est leur effet commun. Restreindre l’étude à S revient à conditionner sur un collisionneur. Cet exemple déterministe simplifie le mécanisme ; dans des données réelles, probabilités et autres causes modifient l’ampleur et parfois le sens. « Ajuster sur toutes les variables disponibles » n’est donc pas une garantie de correction des biais.
Schéma de raisonnement
- Sélection
- Mesure
- Causes communes
- Temporalité
- Analyse de sensibilité
Repères complémentaires, sans ordre ni lien de cause.
Cette liste organise la critique et ne représente pas une chaîne causale. Le graphe de confusion correct possède deux flèches partant de la cause commune.
Exercices progressifs
1. Un questionnaire d'exposition est plus détaillé chez les malades. Quel biais possible ?
2. Augmenter un échantillon corrige-t-il une erreur systématique d'appareil ?
3. Pourquoi ajuster sur un médiateur peut-il changer la question causale ?
4. Un enquêteur connaît le statut de cas et insiste davantage sur certaines expositions. Quel mécanisme ?
5. Un facteur est provoqué par l’exposition puis influence le résultat. Quel rôle possible ?
6. RR = 0,5 dans deux strates implique-t-il des différences de risques égales ?
Corrections argumentées
1. Un biais d'information différentiel, potentiellement lié à la mémorisation ou à l'enquêteur. Son sens et son amplitude nécessitent une analyse du mécanisme.
2. Non. Cela peut réduire l'erreur aléatoire tout en conservant le décalage systématique.
3. Si l'on cherche l'effet total de X sur Y, bloquer le chemin passant par M retire une composante de cet effet. On se rapproche d'une autre cible, sous des hypothèses supplémentaires.
4. Un biais d’information différentiel peut apparaître par la façon de recueillir l’exposition. Il faut examiner comment les réponses sont modifiées.
5. Un médiateur. L’ajuster peut retirer une partie de l’effet total et changer la cible de l’analyse.
6. Non. La baisse absolue dépend du risque initial. À 4 % et 40 %, elle vaut respectivement 2 et 20 points.
Références et portée
Sources consultées le 1er octobre 2026 pour les notions signalées. Développements, situations et calculs pédagogiques OSSIK ; données fictives. La concordance complète avec les supports universitaires de l’année et la relecture scientifique humaine restent à réaliser. Les modèles biomédicaux ne fournissent aucune décision thérapeutique individuelle.
Partie 5 · Standardiser et comparer des populations
Prérequis et objectifs
Savoir calculer une moyenne pondérée et distinguer taux brut et taux par strate. Une population de référence est un outil de comparaison.
À l’issue de ce cours, vous devez pouvoir :
- Réaliser une standardisation directe.
- Interpréter une standardisation indirecte.
- Séparer comparaison ajustée et besoins réels.
Fondements du thème
Lire les taux bruts
Deux territoires fictifs possèdent chacun 10 000 habitants. Le territoire A comprend 8000 personnes jeunes et 2000 personnes âgées ; B comprend 4000 jeunes et 6000 personnes âgées. Pour simplifier, on suppose que la mortalité annuelle vaut 1 pour 1000 chez les jeunes et 20 pour 1000 chez les personnes âgées, dans les deux territoires. Les catégories sont purement pédagogiques et ne constituent pas une définition démographique réelle.
Dans A, le nombre attendu de décès est 8000 × 0,001 + 2000 × 0,020 = 48. Le taux brut vaut 4,8 pour 1000. Dans B, on obtient 4000 × 0,001 + 6000 × 0,020 = 124 décès, soit 12,4 pour 1000. Conclure que le territoire B présente une mortalité plus élevée à âge comparable serait erroné : les taux par groupe d'âge sont identiques par construction.
Standardiser directement
Choisissons une population de référence contenant 50 % de jeunes et 50 % de personnes âgées. Le taux standardisé de A est 0,5 × 1 + 0,5 × 20 = 10,5 pour 1000. Celui de B est exactement le même. La standardisation révèle que l'écart brut provenait ici entièrement de la composition par âge.
Le taux standardisé est une construction comparative ; il ne prédit pas directement le nombre réel de décès dans A ou B. Les besoins locaux restent liés à leurs habitants réels : B peut avoir davantage de besoins associés au vieillissement. Ajuster pour comparer ne signifie donc pas effacer la structure de population dans la planification des soins. Deux indicateurs peuvent être utiles pour deux questions différentes.
Répéter l'exercice avec un véritable écart
Supposons maintenant que B présente 2 décès pour 1000 chez les jeunes et 22 pour 1000 chez les personnes âgées. Son taux standardisé devient 0,5 × 2 + 0,5 × 22 = 12 pour 1000. L'écart ajusté avec A vaut 1,5 pour 1000. Il subsiste donc une différence à structure d'âge de référence identique, mais elle ne prouve pas la responsabilité d'un facteur particulier.
Les niveaux sociaux, expositions, accès aux soins, habitudes de mesure ou autres variables peuvent différer. Une comparaison écologique ne permet pas de déterminer quels individus ont été exposés ni leur risque personnel. Une hypothèse issue de ces données doit être approfondie par un plan permettant de mieux étudier les mécanismes. Une carte est un outil de description et de questionnement, pas une preuve causale automatique.
Développements et raisonnements
La composition de population agit comme un système de poids
Un taux brut est la somme des taux par strate pondérés par les proportions réelles de personnes ou de temps dans ces strates. Deux territoires peuvent donc avoir des taux bruts différents avec les mêmes risques par âge. La standardisation directe utilise des poids communs, ce qui retire cette différence de structure pour la variable stratifiée. Elle ne crée pas une population réelle observée.
Le choix de référence influence les valeurs standardisées. Si une différence entre territoires varie avec l’âge, modifier les poids peut changer l’écart résumé. Il faut utiliser la même référence pour comparer les résultats et préciser sa définition. Le taux standardisé n’est pas une valeur absolue indépendante de toute convention.
Standardisation indirecte
Lorsqu’on dispose de peu de cas dans les strates d’une petite population, les taux locaux peuvent être instables. La standardisation indirecte applique alors des taux de référence aux effectifs ou personnes-temps locaux pour calculer un nombre attendu. Le rapport observé/attendu est un ratio standardisé. Une valeur de 1,2 indique 20 % de plus que l’attendu de cette référence, sans expliquer la cause de l’excès.
Comparer deux ratios indirects peut être délicat si les structures de population diffèrent et si les effets par strate ne sont pas homogènes. Les poids implicites ne sont pas nécessairement les mêmes. Le caractère « standardisé » ne rend donc pas tous les indicateurs interchangeables.
Petits nombres et représentation spatiale
Une zone de faible population peut afficher un taux élevé à partir de quelques événements. L’incertitude doit accompagner la carte ou le classement. Des changements de frontières, de codage ou de complétude du recueil peuvent aussi produire une différence apparente. Une carte ne sépare pas à elle seule ces explications.
| Question | Indicateur utile | Précaution |
|---|---|---|
| Combien de soins organiser ? | Effectifs et besoins réels | Ne pas substituer une population fictive |
| Comparer à structure égale | Standardisation directe | Même référence |
| Observé versus attendu local | Standardisation indirecte | Taux de référence adaptés |
| Identifier une cause individuelle | Données et plan appropriés | Éviter l’erreur écologique |
Une relation entre exposition moyenne d’un territoire et taux de maladie ne décrit pas nécessairement la relation chez les individus. Les personnes exposées et malades peuvent ne pas être les mêmes. L’analyse écologique peut générer une hypothèse et informer une politique territoriale, tout en gardant cette limite.
Atelier de calcul et analyse de sensibilité
Trois strates d’âge possèdent des poids de référence 0,50 ; 0,30 ; 0,20. Les taux d’un territoire sont 1, 5 et 20 pour 1000. Son taux standardisé est 0,50 × 1 + 0,30 × 5 + 0,20 × 20 = 6 pour 1000. Pour un autre territoire aux taux 2, 4 et 18, on obtient 5,8 pour 1000. Le second a un taux plus élevé dans la première strate et plus faible dans les deux autres ; le résumé dépend donc du choix de poids.
Avec une référence donnant 80 % à la première strate, puis 10 % à chacune des autres, les taux deviennent 3,3 et 3,8 pour 1000. Le classement s’inverse. Ce résultat ne révèle pas une erreur de calcul : il montre qu’une hétérogénéité des écarts selon les strates ne se résume pas par un classement universel.
Dans une petite population de 2000 personnes jeunes et 500 âgées, des taux de référence de 1 et 20 pour 1000 donnent 2 + 10 = 12 événements attendus. Si 18 sont observés, le ratio standardisé vaut 1,5. On décrit un excès de 50 % par rapport à l’attendu, avec une incertitude importante compte tenu des 18 événements. On ne peut attribuer cet excès à une pollution ou à l’accès aux soins sans données et plan supplémentaires.
Approfondissement et contrôle du modèle
Une comparaison ajustée n’efface pas la charge de soins
Une population plus âgée peut avoir un taux standardisé comparable à celui d’une population jeune tout en nécessitant davantage de soins en nombre absolu. Pour organiser des ressources, les effectifs réels et les besoins par âge restent pertinents. Pour comparer des risques à structure égale, on utilise un autre indicateur. Ces deux lectures répondent à deux décisions différentes.
Un rapport doit donc éviter de présenter le taux ajusté comme une correction qui rendrait le taux brut inutile. Le taux brut décrit une charge dans une population réelle ; le taux standardisé facilite une comparaison sous des poids communs. Les présenter ensemble avec leurs définitions permet de comprendre à la fois la situation vécue et ce que la structure démographique explique dans l’écart observé.
Mise à l’épreuve : Deux SMR ne sont pas toujours comparables entre eux
Problème. Les taux de référence sont 1 et 10 pour 1000 dans deux strates. A compte 900 personnes dans la première et 100 dans la seconde ; B, 100 puis 900. Si chacun a deux fois les taux de référence, calculer les nombres attendus et observés.
Résolution. Les attendus valent A : 0,9 + 1 = 1,9 ; B : 0,1 + 9 = 9,1. Les observés théoriques valent 3,8 et 18,2, donc les deux SMR valent 2. Les effectifs fractionnaires sont des espérances, pas des décomptes observés. Ici, l’égalité est garantie par le même facteur dans chaque strate. En dehors de cette proportionnalité, chaque SMR résume des strates avec des poids propres ; les comparer comme deux taux standardisés directement peut être trompeur. Toujours préciser la référence, la méthode et les taux par strate disponibles.
Deux rapports standardisés indirects ne sont pas toujours comparables
Les poids restent propres à chaque population
La standardisation indirecte applique des taux de référence aux effectifs par strate de la population étudiée. Le nombre attendu est E=Σn_i r_ref,i ; le rapport standardisé de mortalité, ou SMR, vaut O/E. Cette opération convient lorsque les taux internes par strate sont peu stables, mais ses poids dépendent de la population étudiée.
Si deux populations ont des structures différentes et des rapports de taux différents selon les strates, leurs SMR ne portent pas sur la même moyenne de ces rapports. Classer leurs SMR comme si l'on comparait deux taux directement standardisés sur une structure commune peut donc tromper.
Démonstration par un contre-exemple
Deux strates ont des taux de référence fictifs de 1 et 10 pour 1000. Les populations A et B ont exactement les mêmes taux internes par strate : 2 et 10 pour 1000. A contient 9000 personnes dans la première strate et 1000 dans la seconde ; B, 1000 puis 9000.
Calcul. Pour A, O=18+10=28 et E=9+10=19, donc SMR=1,4737. Pour B, O=2+90=92 et E=1+90=91, donc SMR=1,0110. Les SMR diffèrent fortement alors que les deux taux internes par strate sont identiques. L'écart des SMR vient des poids appliqués aux excès relatifs.
Exercice : construire une comparaison commune
Standardiser directement A et B sur une population composée pour moitié de chaque strate. Correction. Chaque taux standardisé vaut 0,5×2+0,5×10=6 pour 1000. La comparaison retrouve leur identité à structure commune. Cela n'affirme pas que leurs nombres réels d'événements sont identiques : les effectifs et structures restent différents.
Une standardisation ne supprime que les différences de composition prises en compte dans ses strates. Confusion résiduelle, différences de diagnostic et qualité des dénominateurs restent possibles. Les effectifs attendus ne sont pas des prévisions individuelles ; ils décrivent le scénario de référence explicité. La méthode doit donc être accompagnée de la population standard, des strates, de la période et de l'incertitude.
Schéma de raisonnement
- Strates communes
- Taux propres à chaque population
- Poids de référence communs
- Somme pondérée
- Comparaison limitée
Schéma de principe : lire les conditions et les limites dans le texte.
Les poids communs servent à comparer. Le taux obtenu ne prédit pas directement le nombre d’événements dans la population réelle.
Exercices progressifs
1. Dans le premier scénario, lequel des territoires a le plus de décès en nombre absolu ?
2. Pourquoi les taux standardisés sont-ils égaux malgré des taux bruts différents ?
3. Peut-on utiliser 10,5 pour 1000 pour annoncer directement 105 décès attendus dans chaque territoire réel ?
4. Avec des taux 2 et 12 pour 1000 et des poids 0,75 et 0,25, calculer le taux standardisé.
5. Un nombre attendu vaut 40 et l’observé 30. Ratio standardisé ?
6. Pourquoi deux taux standardisés avec des références différentes ne se comparent-ils pas directement ?
Corrections argumentées
1. B, avec 124 décès attendus contre 48. Cette différence compte pour décrire une charge réelle, même si elle ne traduit pas un excès à âge égal.
2. Les taux par âge sont identiques et on leur applique les mêmes poids. On retire l'effet de structure pour cette comparaison.
3. Non. La composition réelle n'est pas 50/50 dans les territoires. Le taux standardisé décrit une population fictive de référence.
4. 0,75 × 2 + 0,25 × 12 = 4,5 pour 1000.
5. 30/40 = 0,75, soit 25 % de moins que l’attendu de la référence. Il faut encore discuter l’incertitude.
6. Les poids des strates changent. Une différence peut refléter la référence autant que les taux spécifiques ; il faut harmoniser le calcul.
Références et portée
Sources consultées le 1er octobre 2026 pour les notions signalées. Développements, situations et calculs pédagogiques OSSIK ; données fictives. La concordance complète avec les supports universitaires de l’année et la relecture scientifique humaine restent à réaliser. Les modèles biomédicaux ne fournissent aucune décision thérapeutique individuelle.
Ce cours, en cartes de révision
Lire un cours ne suffit pas à le retenir. Dépose ce cours, ou le poly de ta fac, dans Ossik : il en sort des cartes sourcées à la page, qu’il te ressort au bon moment.